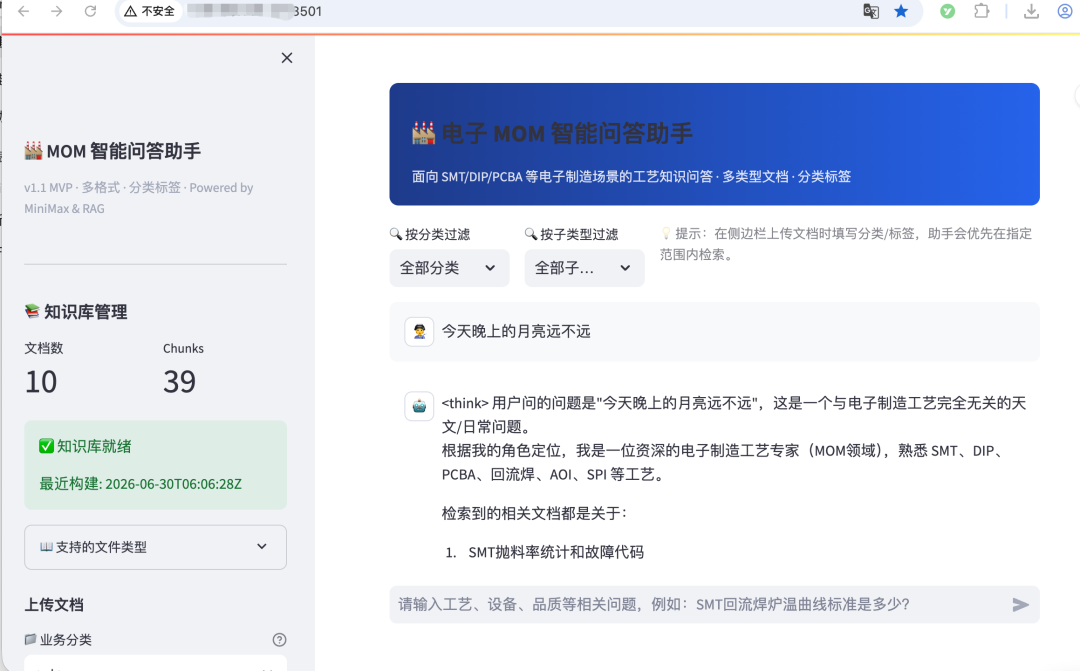
MOM智能问答助手MVP版本已经跑通得到初步验证,项目中涉及到技术点很多,关键核心的几点我想做个系列分享。有两个原因:
第一,给自己做一次系统性梳理。代码能跑通,不代表原理真懂了。把理解写出来,是检验认知最直接的方式。
第二,给同样在路上的开发者一块垫脚石。如果能提供一点思路就值了。
这篇文章就把RAG(检索增强生成)这件事从头到尾讲清楚。
一、为什么需要RAG?先看一个场景
假设你是电子厂的工艺工程师,车间问:“回流焊预热区升温速率标准是多少?”
你手边有一份几十页的《回流焊工艺规范.md》。传统做法是:打开文档 → Ctrl+F 搜索“预热” → 读到对应段落 → 把答案复制给车间。
这个过程的问题很明显:每次都要人工翻,效率低;新人不知道去哪翻,只能问老员工。
那如果让AI来做呢?
直接问通用大模型(比如让一个人背下所有知识,然后考他):
Q:“回流焊预热区升温速率是多少?”
A:“通常在1.0~3.0℃/s之间,具体视焊膏型号而定……”
这个回答“像”是对的,但仔细一看——不是你的工艺规范里的数值。你的规范写的是1.5~2.5℃/s。
这就叫 “幻觉” 。LLM(大语言模型)很擅长“像那么回事”地说话,但它会编造它不知道的东西。
所以,我们要的不是一个“背过书但会乱说”的AI,而是一个 “允许开卷考试”的AI。
这就是RAG的核心思想:
RAG = 检索(Retrieve)+ 生成(Generate)
先根据你的问题去知识库里找相关的资料,再把资料连同问题一起交给AI,让它“看了资料再回答”。
二、RAG的工作原理:两个阶段,五个步骤
RAG分为离线阶段(准备知识库)和在线阶段(回答用户提问)。
离线阶段:把文档变成“可搜索的格式”
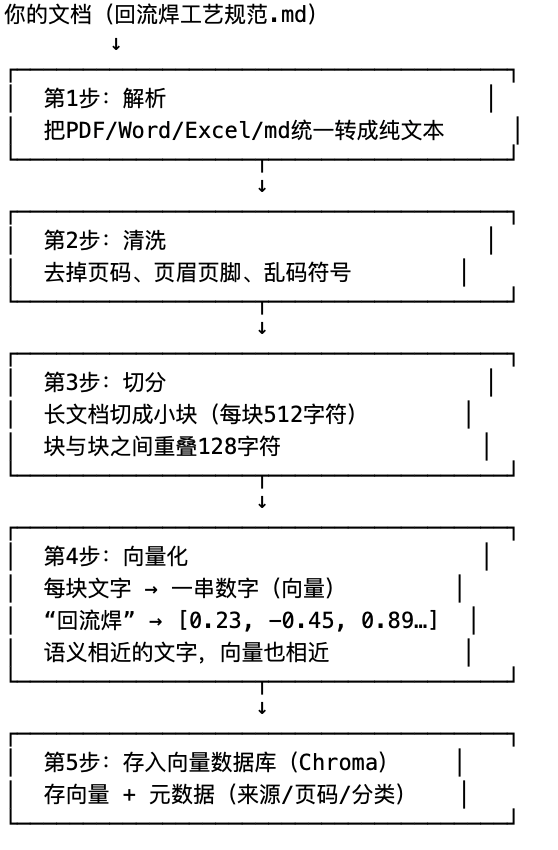
为什么需要向量化?
计算机不认识汉字,但它认识数字。向量就是把“语义”翻译成“数学”的过程:
“回流焊工艺标准” → [0.23, -0.45, 0.67, …]“预热区温度曲线” → [0.21, -0.43, 0.65, …]“今天天气真好” → [0.89, 0.12, -0.34, …]
前两个向量在数学空间里离得近,第三个离得远。所以当用户问“回流焊温度是多少”时,系统能找到“回流焊工艺标准”这个块,而不会找到“今天天气真好”。
在线阶段:用户提问时的流程
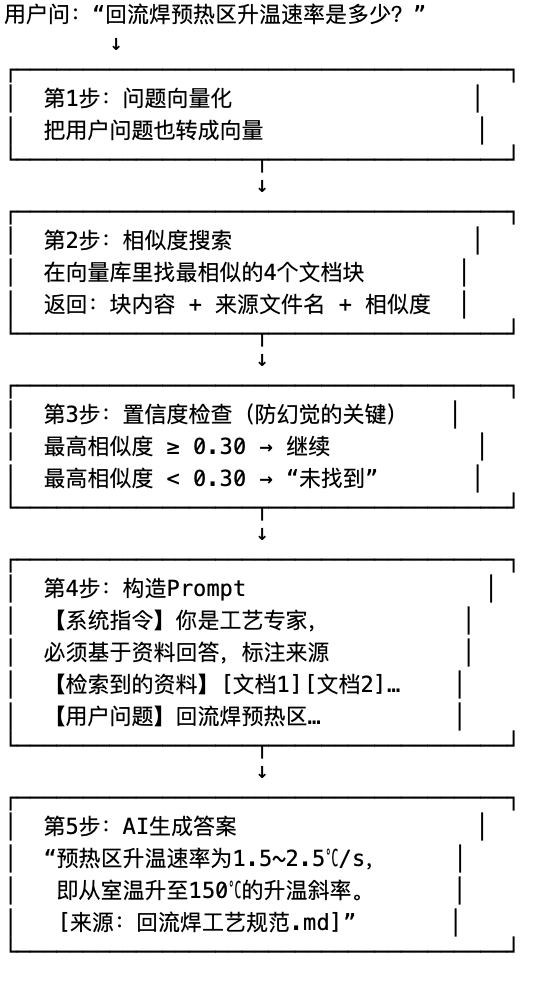
这个流程的核心价值在于:AI不是凭记忆回答,而是“看了资料再说话”。 就像开卷考试,答案有据可查。
三、项目中的关键实现:六个配置旋钮
理解原理之后,再看代码就清晰很多。
本项目RAG模块的核心代码位置:
模块
文件
说明
检索逻辑
app/core/retriever.py
向量相似度搜索
生成逻辑
app/core/rag_engine.py
RAG流程编排器
向量化模型
app/core/embedder.py
文本→向量
LLM调用
app/core/llm_client.py
调用大模型API
配置管理
app/config.py / .env
参数配置
其中有6个关键参数,直接影响回答质量:
参数
当前值
作用
调大
调小
CHUNK_SIZE
512
每块多大(字符)
答案更完整
检索更精准
CHUNK_OVERLAP
128
块之间重叠
上下文连贯
可能丢失边界
TOP_K
4
检索几个块
信息更全
更快、更聚焦
CONFIDENCE_THRESHOLD
0.30
最低相似度阈值
更保守、少幻觉
能回答更多问题
EMBEDDING_MODEL
bge-small-zh
“眼睛”模型
—
—
LLM_MODEL
MiniMax-2.7-highspeed
“大脑”模型
—
—
Prompt模板是控制回答质量的另一个关键:
你是一位电子制造工艺专家,请严格基于检索到的文档回答。``回答要求:给出明确、可执行的答案;引用时标注 [来源:文件名];如果文档中没有相关信息,明确说“未找到”;禁止编造文档中没有的参数或数值。
这套Prompt回答了三个问题:
- 你是谁? ——工艺专家
- 你用什么回答? ——检索到的文档
- 你不能做什么? ——编造、瞎说
四、迭代方向:从能用走向好用
当前版本走通了核心链路,但要达到可交付给业务部门使用的成熟度,还有几个优化方向。我在整理时按优先级分了三级:
🔴 高优先级
- 混合检索
当前只用向量检索,对精确词(设备型号、工单编号)不够敏感。
优化:向量 + 关键词(BM25)双路召回,合并后重新排序。
- 检索重排序(Rerank)
当前直接按向量相似度排序,可能存在“向量相似 ≠ 语义相关”的问题。
优化:用专门的Rerank模型(如BAAI/bge-reranker)对候选块重新打分。
- 对话历史记忆
当前每次问答独立,无法追问。
优化:记录最近几轮对话,支持“那有铅的呢?”这类继承上下文的问题。
- 结构感知切分
当前按固定512字符切分,可能把表格、代码块切碎。
优化:保持表格完整、代码块完整、按标题层级切分。
🟡 中优先级
- 答案质量自动评估
当前靠用户👍/👎反馈。优化:自动评估答案与检索内容的匹配度,低分答案告警。
- 增量更新
当前知识库更新需要全量重建。优化:支持单文档增删改。
🟢 低优先级
- 知识图谱增强
提取文档中的实体关系(如“SMT包含印刷、贴片、回流焊”),辅助检索。
- 个性化回答
根据用户角色(新手/专家)返回不同颗粒度的答案。
五、做这个项目,我学到了什么
- RAG不是黑魔法,是标准流水线
它本质上是一套清晰的数据流水线:解析→清洗→切分→向量化→存储→检索→生成。每一步都有明确的输入输出,理解了这个流水线,就理解了80%的RAG。
- 幻觉不是不可避免,但要有意识地防御
防幻觉的核心是三点:
- 置信度阈值:相似度太低直接拒答
- Prompt约束:明确告诉AI“不知道就说不知道”
- 强制引用:答案必须有出处
三者缺一不可。
- 配置参数比你想的更重要
CHUNKSIZE、TOPK、CONFIDENCE_THRESHOLD这些参数,不是随便填的。它们共同决定了系统的“性格”:是保守还是激进,是全面还是精准。理解每个参数的影响,才能真正掌控系统行为。
- 从“能用”到“好用”,还有很长的路
MVP跑通只是第一步。混合检索、Rerank、对话记忆、增量更新……这些不是锦上添花,是生产环境的必需品。
写在最后
这篇文章是我对RAG的一次系统性梳理。它的价值不在于“多深”,而在于“多真”——每个概念都经过了亲手调试和验证。